Gepubliceerd op: 16 okt 2026

Waarom is data governance belangrijk voor datagestuurde organisaties?
AuteurMike van DamFunctieData Engineer

Tag(s)

Data governance Expert

Wat is data governance?

Data Governance is de manier waarop organisaties gegevens op grote schaal bruikbaar maken

Data Governance wordt vaak geassocieerd met compliance, documentatie of toezicht door het management. Die aspecten zijn belangrijk, maar vormen niet het hoofddoel. In wezen gaat data governance over het bruikbaar maken van data binnen de hele organisatie door duidelijkheid te scheppen over welke data beschikbaar is, welke data betrouwbaar is en wie verantwoordelijk is voor data, definities en wijzigingen.

Dit wordt steeds belangrijker naarmate organisaties hun dataplatforms, analysemogelijkheden, selfservice BI-initiatieven, dataproducten en AI-toepassingen uitbreiden. Zonder governance leidt groei vaak tot complexiteit: meerdere versies van dezelfde metric, onduidelijke verantwoordelijkheid, inconsistente definities en beperkt vertrouwen in rapporten of modellen. Met effectieve governance wordt diezelfde groei schaalbaar, omdat teams weten waar ze gegevens kunnen vinden, hoe betrouwbaar deze zijn en wie ze moeten inschakelen wanneer definities of dataproducten moeten worden aangepast.
AuteurMike van DamFunctieData Engineer

Tag(s)

Data governance Expert

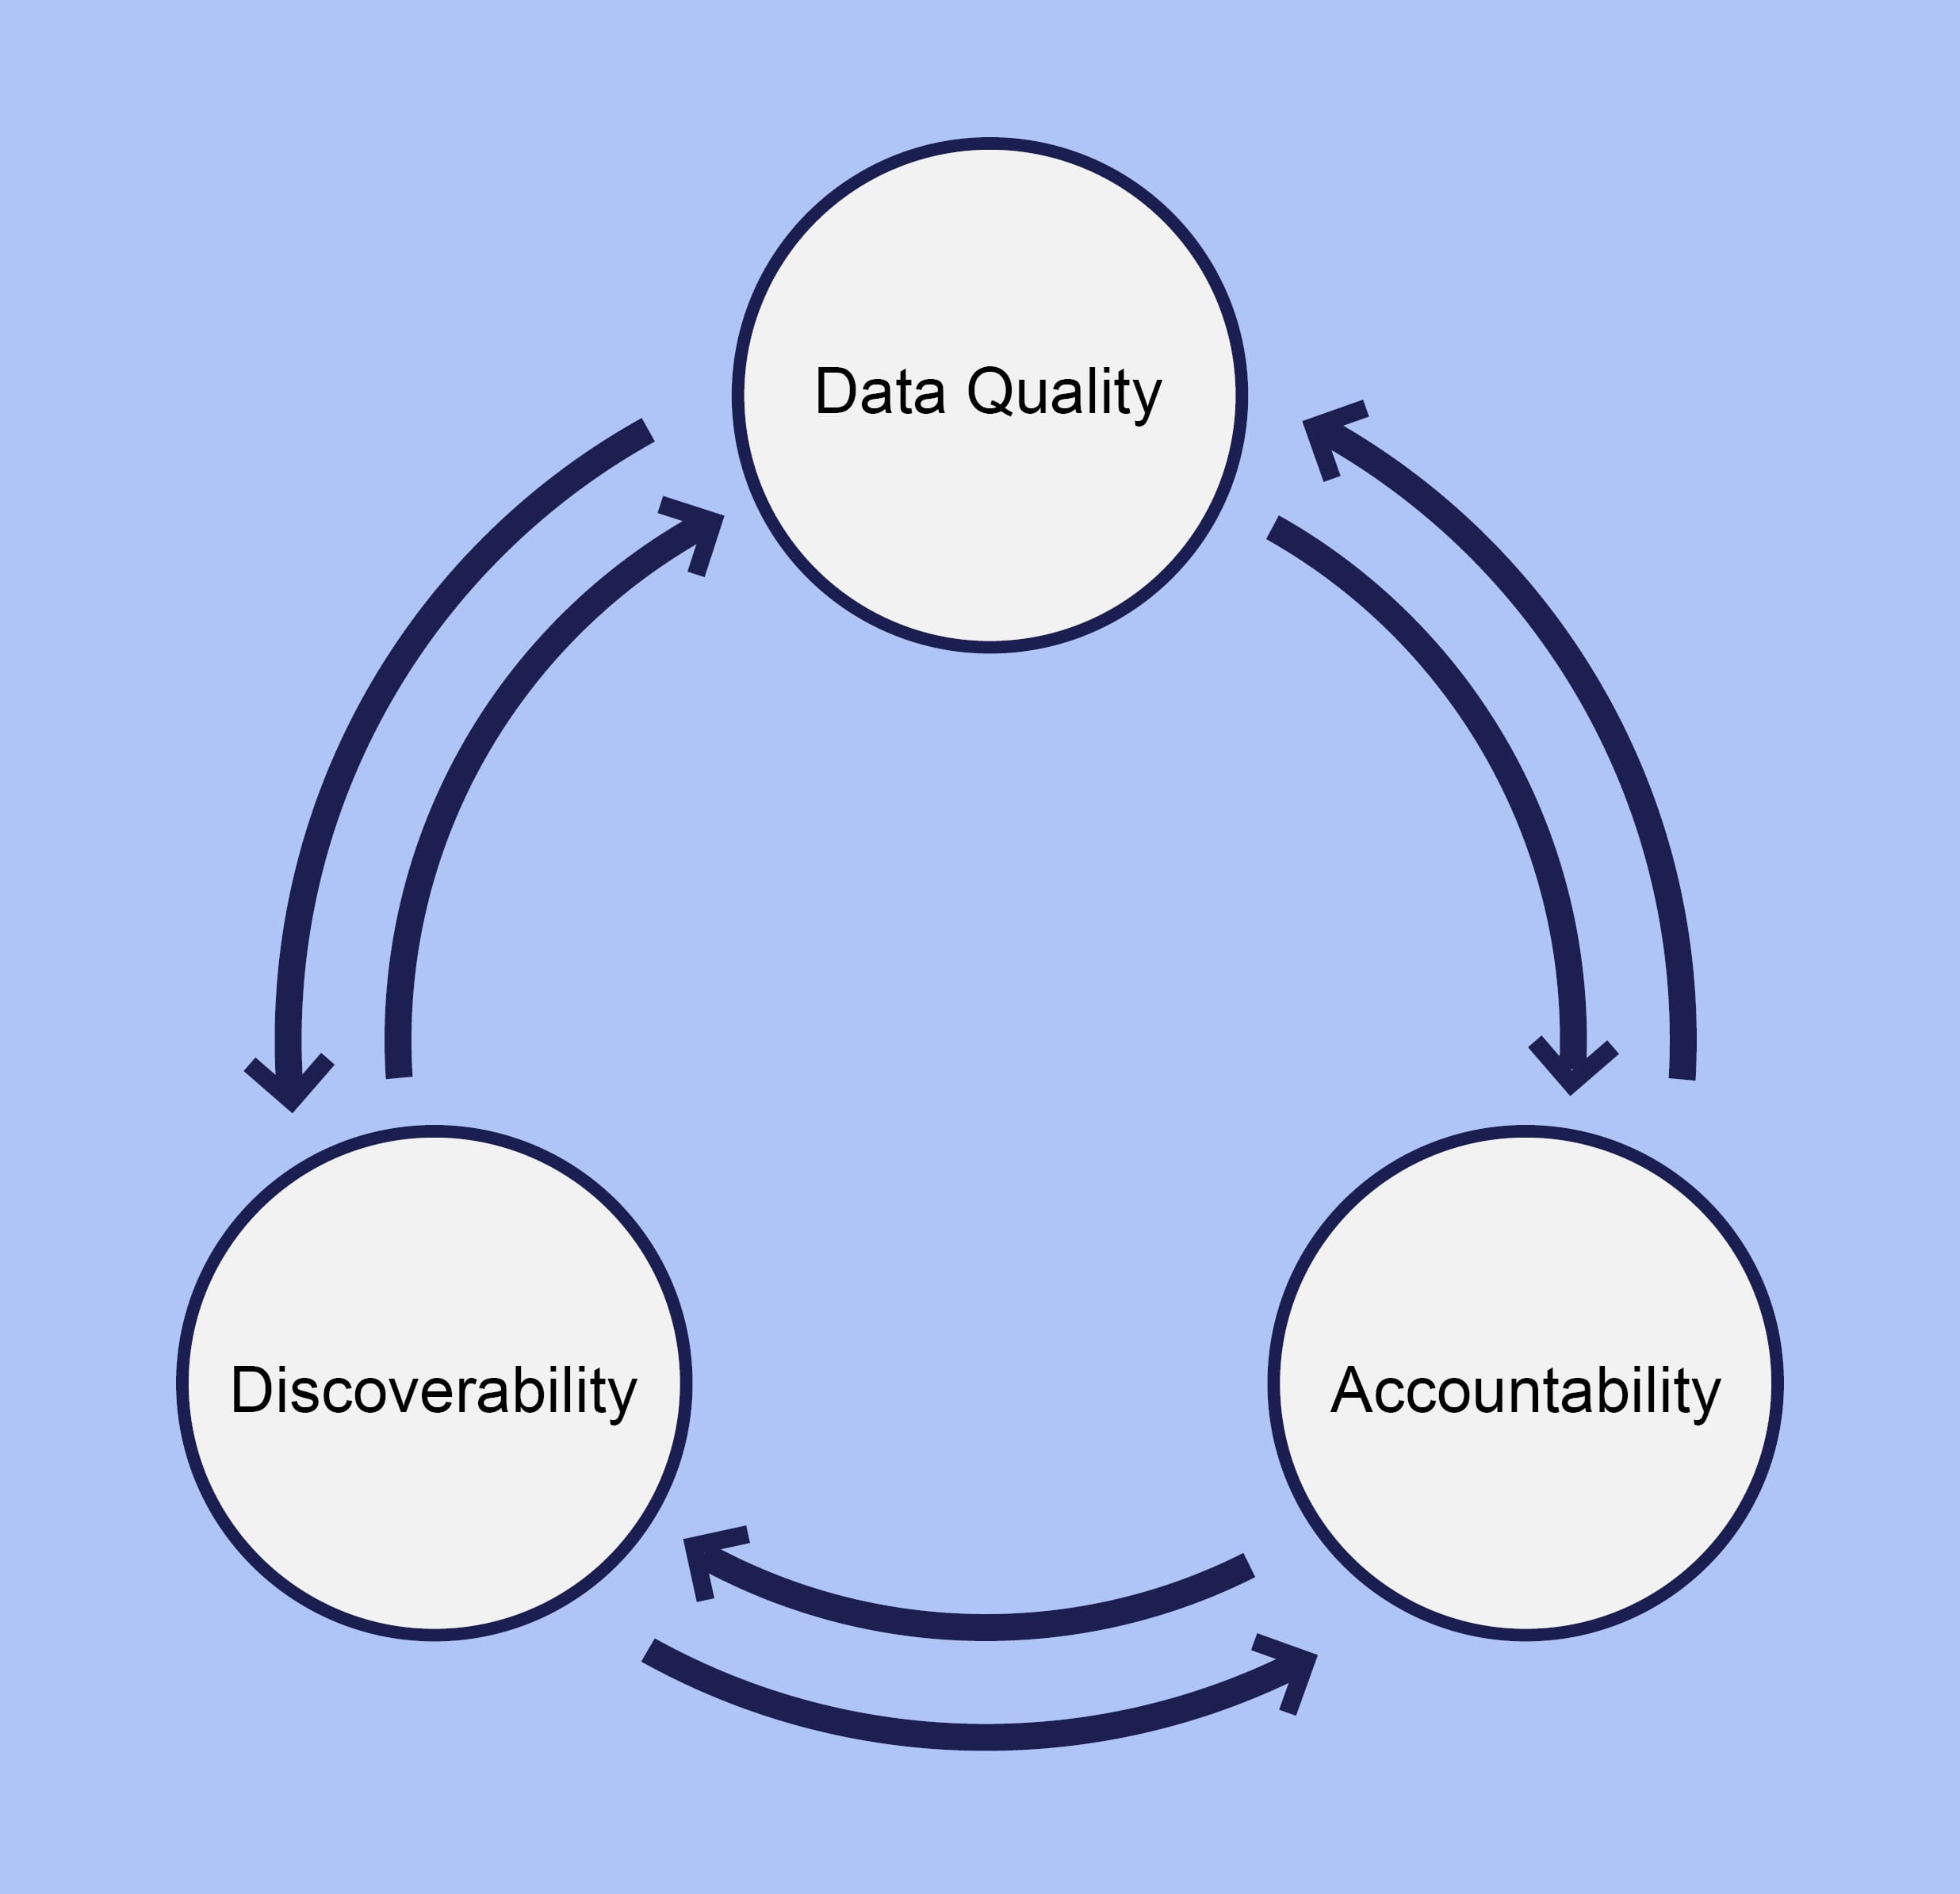
In eerdere blogberichten hebben we drie praktische pijlers van datagovernance beschreven: accountability en eigendom, data quality, en discoverability van data en metadata. Deze pijlers zijn het meest effectief wanneer ze elkaar versterken. Duidelijke eigendom maakt het gemakkelijker om de datakwaliteit te verbeteren en definities te handhaven. Betrouwbare kwaliteit vergroot het vertrouwen en het gebruik. Sterke metadata en vindbaarheid helpen gebruikers het juiste dataproduct te vinden, de context ervan te begrijpen en de verantwoordelijke eigenaar te identificeren.

Wat zijn de zakelijke voordelen van data governance?

Een goed geïmplementeerde aanpak van datagovernance creëert bedrijfswaarde door de drempels bij het gebruik van data te verlagen. Het remt de organisatie niet af, maar geeft teams de duidelijkheid die ze nodig hebben om sneller en met vertrouwen te handelen.

  • Betere dataproducten ontwikkelen in minder tijd:

    Duidelijke verantwoordelijkheid helpt teams om de ontwikkeling van dataproducten af te stemmen op de zakelijke prioriteiten. Een eigenaar van een dataproduct kan bepalen welke use cases het belangrijkst zijn, definities met belanghebbenden verduidelijken en voorkomen dat ontwikkelteams tijd besteden aan functies die geen waarde toevoegen. Zo wordt het bijvoorbeeld eenvoudiger om een dashboard voor verkoopprestaties te realiseren en in gebruik te nemen wanneer één eigenaar verantwoordelijk is voor de definities van de statistieken, de kwaliteitsverwachtingen en wijzigingsverzoeken.

  • Snellere en betere zakelijke beslissingen mogelijk maken:

    Besluitvormers moeten niet alleen weten waar ze gegevens kunnen vinden, maar ook of ze deze kunnen vertrouwen. Wanneer definities, kwaliteitsindicatoren en verantwoordelijkheid zichtbaar zijn, besteden managers minder tijd aan het op één lijn brengen van tegenstrijdige cijfers en meer tijd aan het ondernemen van actie op basis van inzichten.

  • Toenemende acceptatie van analytics en selfservice-BI:

    Zakelijke gebruikers maken eerder gebruik van dataproducten wanneer ze begrijpen wat de gegevens betekenen, waar ze vandaan komen en wie erachter staat. Wanneer de financiële afdeling bijvoorbeeld actief verantwoordelijk is voor een intern Power BI-rapport en dit toelicht, zijn gebruikers eerder geneigd het rapport te vertrouwen en het te gebruiken bij terugkerende besluitvorming.

  • Een schaalbare basis voor groei creëren:

    Naarmate dataplatforms uitbreiden, helpt governance om dubbele datasets, onduidelijke verantwoordelijkheid en inconsistente definities te voorkomen. Dit is vooral belangrijk wanneer organisaties overstappen van een klein aantal centraal beheerde rapporten naar een breder ecosysteem van dataproducten, analytische teams en AI-gestuurde workflows. Ook compliance profiteert van deze duidelijkheid, maar dit wordt een natuurlijk gevolg van goed bestuur in plaats van het enige doel.

Waarom is data governance belangrijk voor AI?

De invoering van AI maakt datagovernance nog belangrijker. AI-initiatieven slagen er vaak niet in om op te schalen, niet omdat het model zwak is, maar omdat de onderliggende gegevensbasis onduidelijk is. Als een AI-oplossing niet de juiste bron kan identificeren, de bedrijfsdefinitie niet begrijpt, de gegevenskwaliteit niet kan beoordelen of de eigendoms- en toegangsregels niet respecteert, zal de output ervan moeilijk te vertrouwen zijn.

AI is afhankelijk van betrouwbare datakwaliteit

Modellen, copiloten en analytische agents zijn slechts zo nuttig als de data die ze verwerken. Als klant-, omzet- of operationele gegevens onvolledig, inconsistent of slecht gedefinieerd zijn, kan AI resultaten opleveren die er overtuigend uitzien, maar tot verkeerde beslissingen leiden. Governance vermindert dit risico door kwaliteitsverwachtingen expliciet te maken en door verantwoordelijkheid toe te wijzen voor het monitoren en verbeteren van kritieke gegevens.

AI heeft behoefte aan goede vindbaarheid en metadata.

Bij traditionele rapportage kiezen gebruikers vaak een vooraf gedefinieerd dashboard of een dataset. Bij AI-gestuurde analyses kan een gebruiker simpelweg een vraag stellen, zoals: „Wat was de omzet van afdeling X vorig jaar?“ Om dit correct te beantwoorden, moet het systeem de juiste dataset vinden, de goedgekeurde definitie van omzet begrijpen, de juiste filters toepassen en de relevante toegangsregels naleven. Een datacatalogus, een duidelijke bedrijfswoordenlijst, herkomstinformatie en een eigendomsmodel helpen dit mogelijk te maken.

AI vereist strengere controle over gevoelige gegevens

Het gebruik van grote taalmodellen brengt extra risico’s met zich mee, met name wanneer deze zijn getraind op of gebaseerd zijn op gevoelige bedrijfsgegevens. Omdat deze modellen patronen leren uit de gegevens die ze verwerken, kan het onnodig blootstellen van vertrouwelijke, persoonlijke of bedrijfseigen informatie leiden tot risico’s op het gebied van privacy, beveiliging en naleving. Datagovernance helpt deze risico’s te beperken door te bepalen welke gegevens geschikt zijn voor elke AI-toepassing, de toegang van het model te beperken tot alleen de gegevens die nodig zijn, en ervoor te zorgen dat gevoelige gegevens worden geclassificeerd en beschermd tegen verwerking wanneer ze niet nodig zijn. Dit vereist dat organisaties inzicht hebben in de herkomst, gevoeligheid en levenscyclus van hun gegevens en dat zij gedurende de gehele AI-levenscyclus passende toegangs- en gebruiksbeperkingen handhaven.

Van technisch bezit tot betrouwbare bedrijfscapaciteit

Bij datagovernance gaat het niet om het toevoegen van bureaucratie rondom data. Het is de manier waarop organisaties data omzetten van een technisch bezit in een betrouwbare zakelijke capaciteit. Wanneer governance duidelijkheid schept over beschikbaarheid, kwaliteit, definities en eigendom, kunnen teams betere beslissingen nemen, het gebruik van dataproducten vergroten, analyses opschalen en een sterker fundament voor AI leggen. De werkelijke waarde van datagovernance ligt daarom niet in het governance zelf. Het gaat om wat de organisatie kan bereiken zodra mensen en systemen met vertrouwen de juiste gegevens kunnen vinden, begrijpen en gebruiken.

Wilt u zien hoe effectieve datagovernance er in de praktijk uitziet? Ontdek hoe Blenddata organisaties helpt bij het creëren van schaalbare, betrouwbare gegevensplatforms en bij het omzetten van governanceprincipes in werkbare oplossingen.

Wat houdt effectief bestuur voor uw bedrijf in?

We helpen je graag op weg.

Contact

Roel Smits

Co-founder | Data Architect