Vraag vijf engineers wat RAG is, en je krijgt vijf versies van dezelfde zin: “je haalt een paar documenten op, stopt die in een prompt en laat het model antwoorden.” Die beschrijving is niet fout, maar wel zo’n twee jaar verouderd. En belangrijker: ze verhult hoeveel architecturale keuzes er onder die ene zin zitten.
Naive RAG werkt prima in een demo: query embedden, top-k ophalen uit een vector-index, in je prompt stoppen, klaar. Zet diezelfde pipeline in een enterprise-omgeving neer, met event-driven document-updates, sessiestatus, agentic tool-calls en strikte toegangscontrole, en de eenvoud verdwijnt.
Een goede RAG-architectuur gaat daarom veel verder dan retrieval en generation. Voor enterprise AI bepalen ook indexering, storage, orchestratie, monitoring, governance en toegangsbeheer of Retrieval-Augmented Generation betrouwbaar in productie kan draaien.
Dit is geen artikel over waarom RAG werkt. We kijken naar de architecturale bouwstenen eronder: welke RAG-patronen er zijn, welke infrastructuur elk patroon vereist en welke keuzes je moet maken rond orchestratie, storage, monitoring en security.

RAG (Retrieval-Augmented Generation) is een AI-architectuur waarbij een taalmodel tijdens het beantwoorden van een vraag relevante informatie uit externe databronnen ophaalt en als context gebruikt voor het genereren van een antwoord.
Een taalmodel heeft uit zichzelf geen toegang tot interne documenten of actuele bedrijfscijfers. Zonder aanvullende context genereert het antwoorden op basis van zijn trainingsdata, met hallucinatie als risico.
Een eenvoudige RAG-pipeline bestaat uit drie stappen:
Dat is de kern. De complexiteit van een production-ready RAG-architectuur zit vooral in alles eromheen: hoe je de index bouwt en synchroon houdt, hoe retrieval wordt getriggerd, waar sessiestatus leeft en hoe je embeddings versioned wanneer je van model wisselt.
Een traditioneel dataplatform is geoptimaliseerd voor aggregatie: geef me bijvoorbeeld de som van alle sales, gebruikmakend van batch-ETL en een lakehouse of warehouse als bron van waarheid.
GenAI-workloads optimaliseren voor iets anders. Daar wil je specifieke, relevante informatie snel terugvinden, met semantische in plaats van alleen SQL-gebaseerde toegang en met een lage latency.
Dat vraagt niet om vervanging van je warehouse. Het vraagt om een aanvullende laag ernaast: de AI execution plane.
Beide lagen kunnen dezelfde onderliggende data gebruiken, maar benaderen die anders. Vector-indexen komen naast tabellen te staan, semantic search naast SQL-queries. De bestaande data-infrastructuur blijft daarmee de fundering, terwijl de AI execution plane data op een andere manier beschikbaar maakt voor LLM’s en AI-applicaties.
RAG is geen eenheidsworst. Afhankelijk van hoe snel een antwoord beschikbaar moet zijn, of een gesprek geheugen nodig heeft en of het systeem zelfstandig acties moet uitvoeren, kom je uit bij verschillende architectuurpatronen.
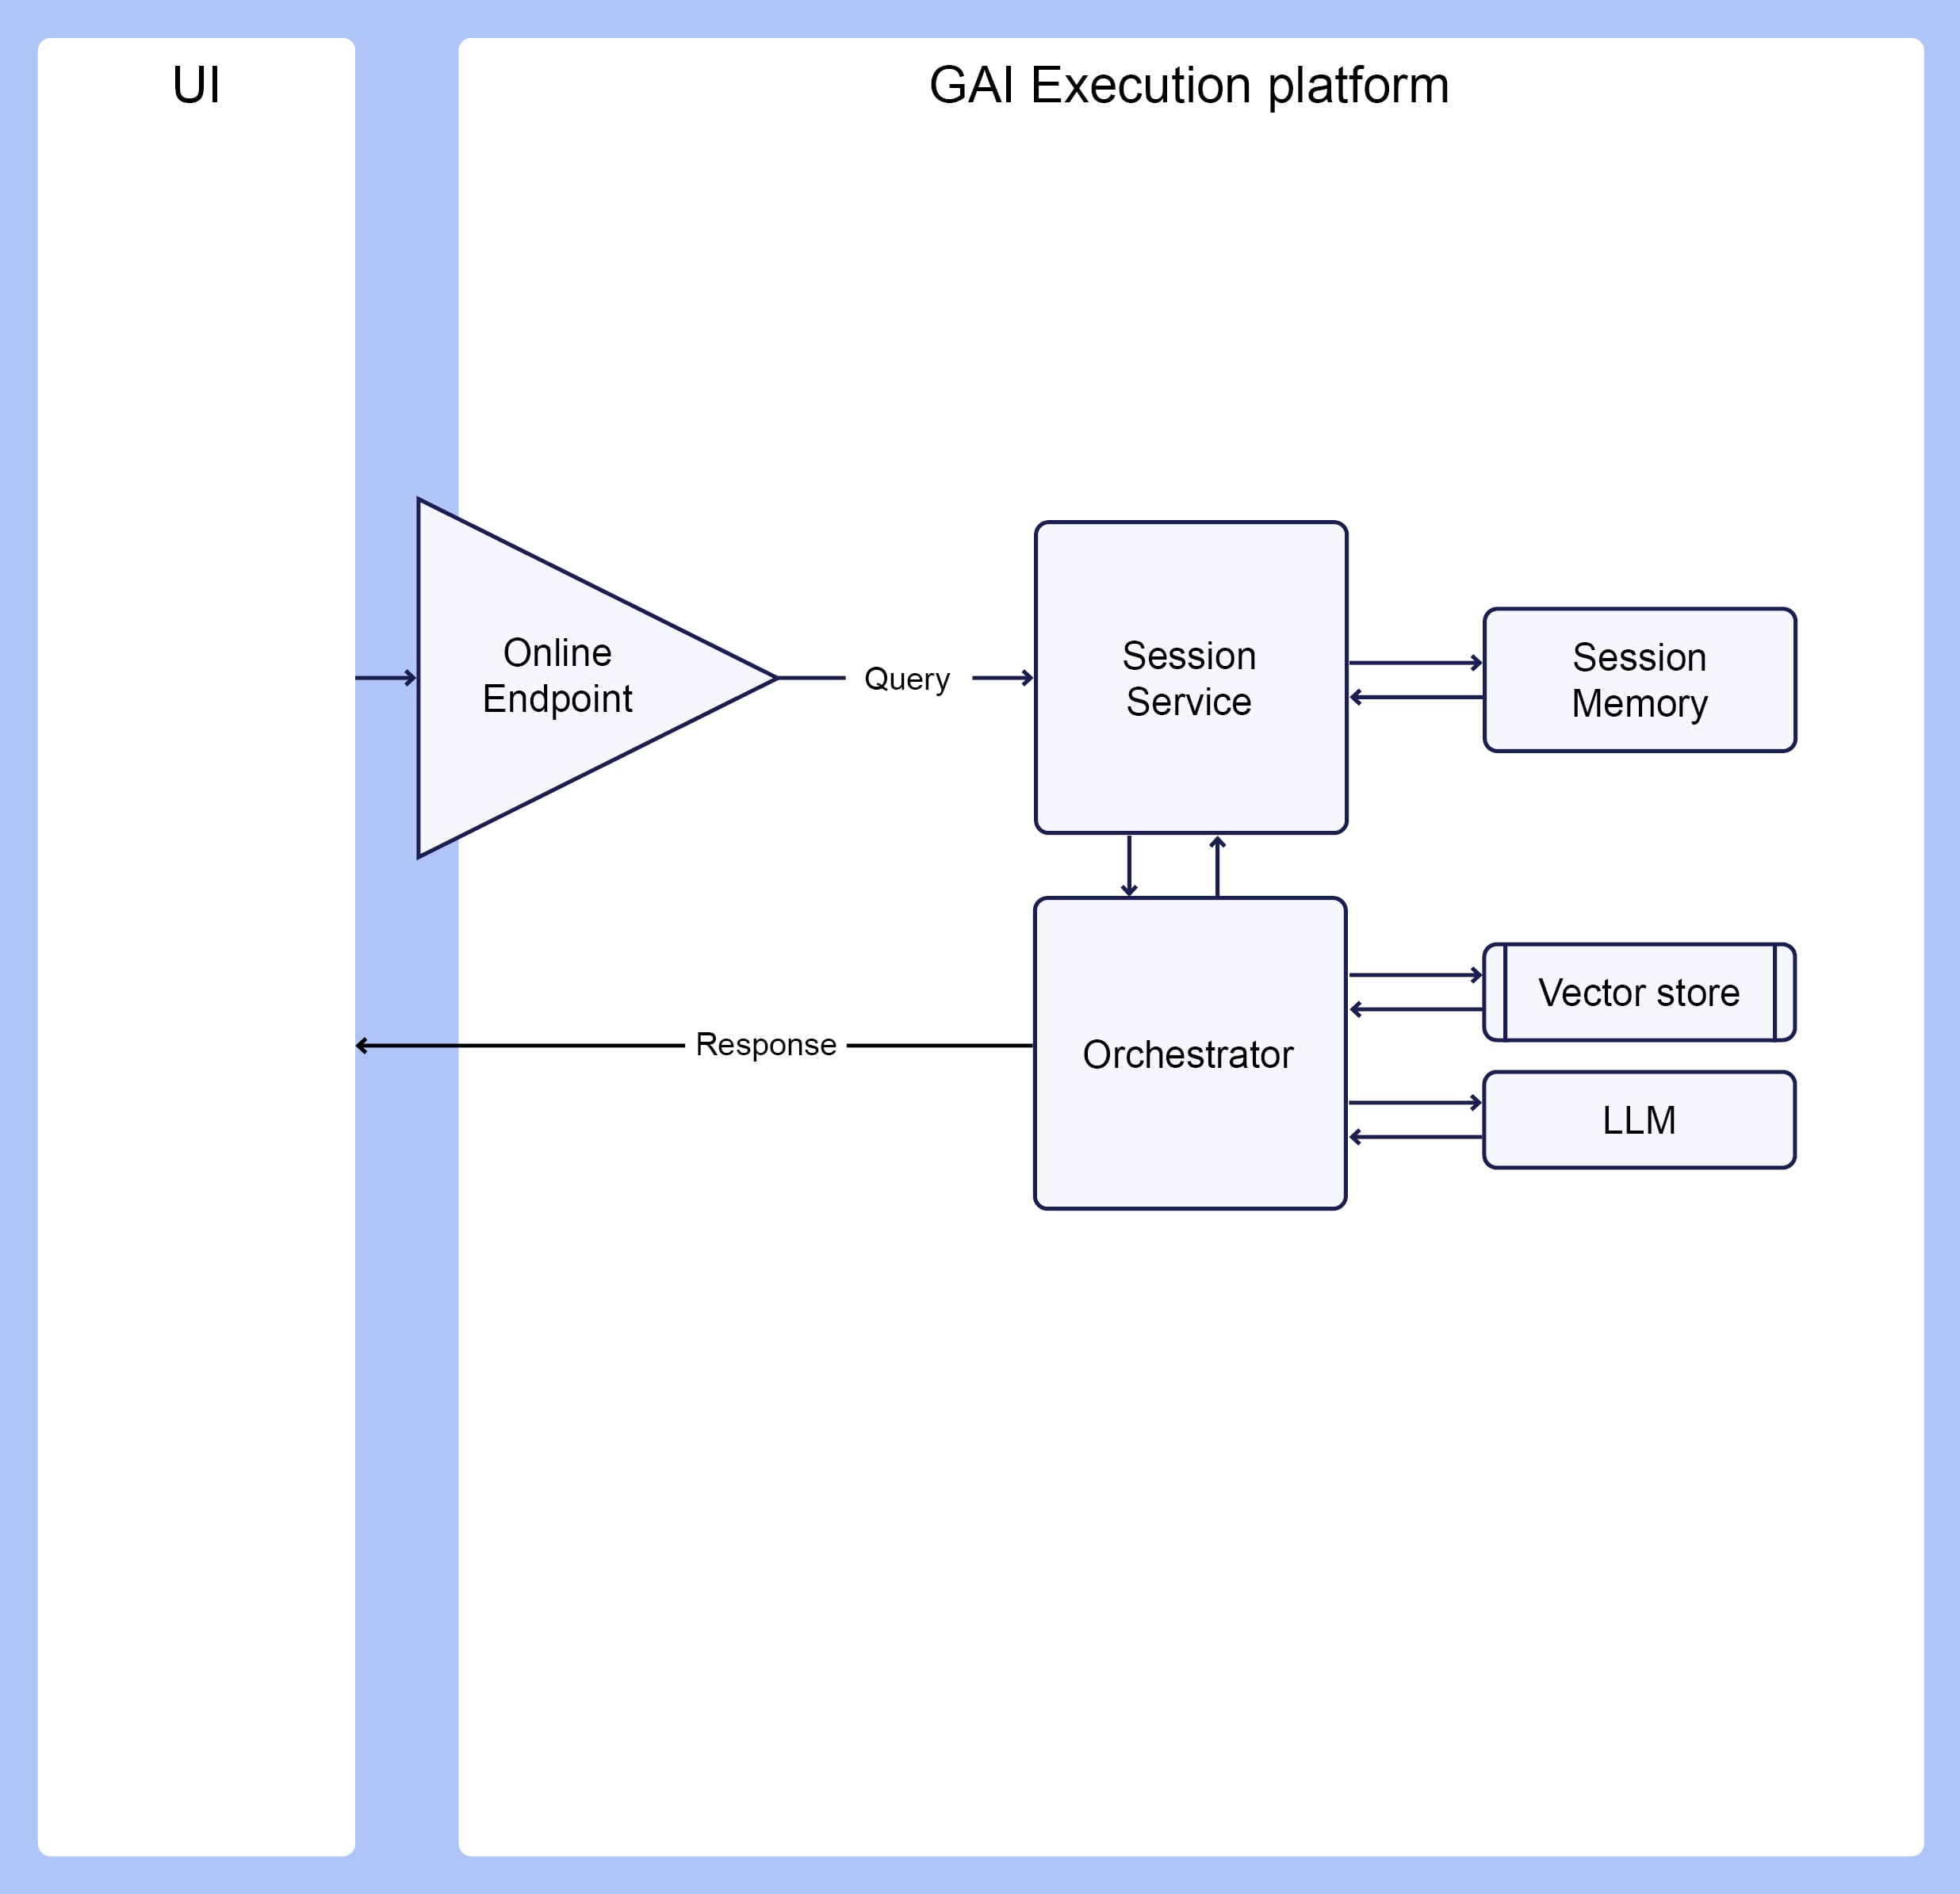
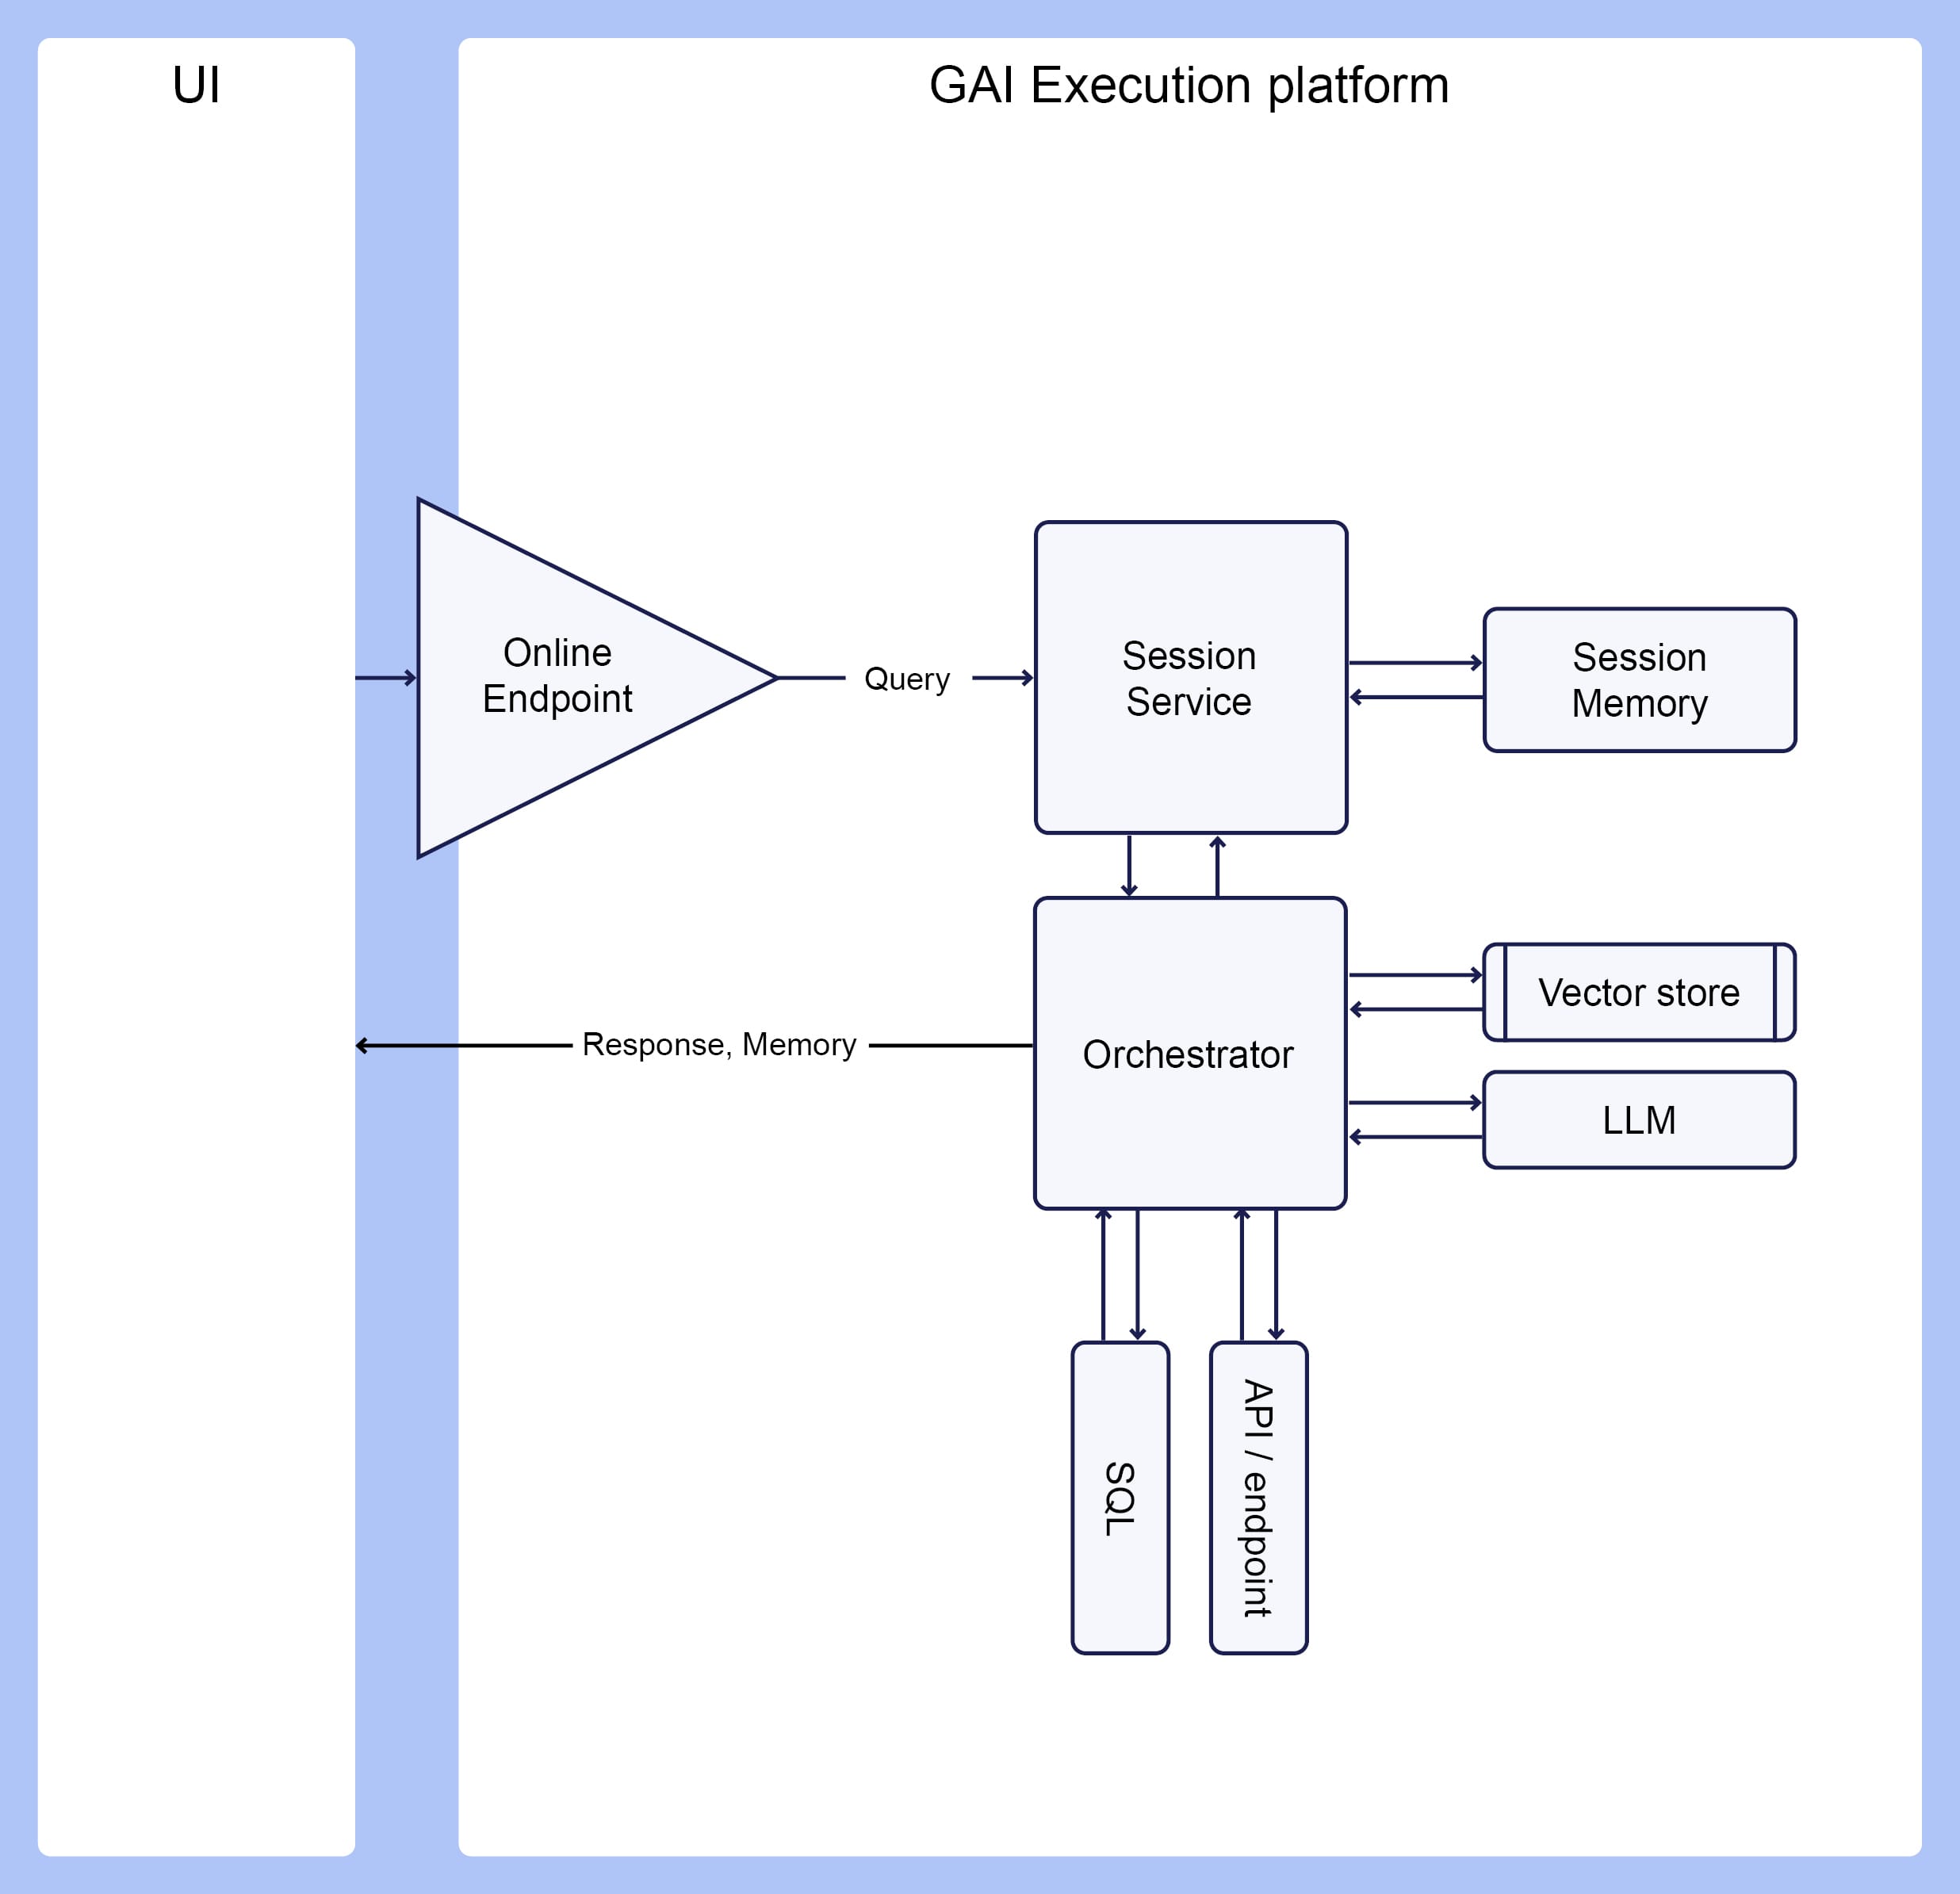
De vijf patronen bouwen deels op elkaar voort. Onder de realtime patronen ligt dezelf

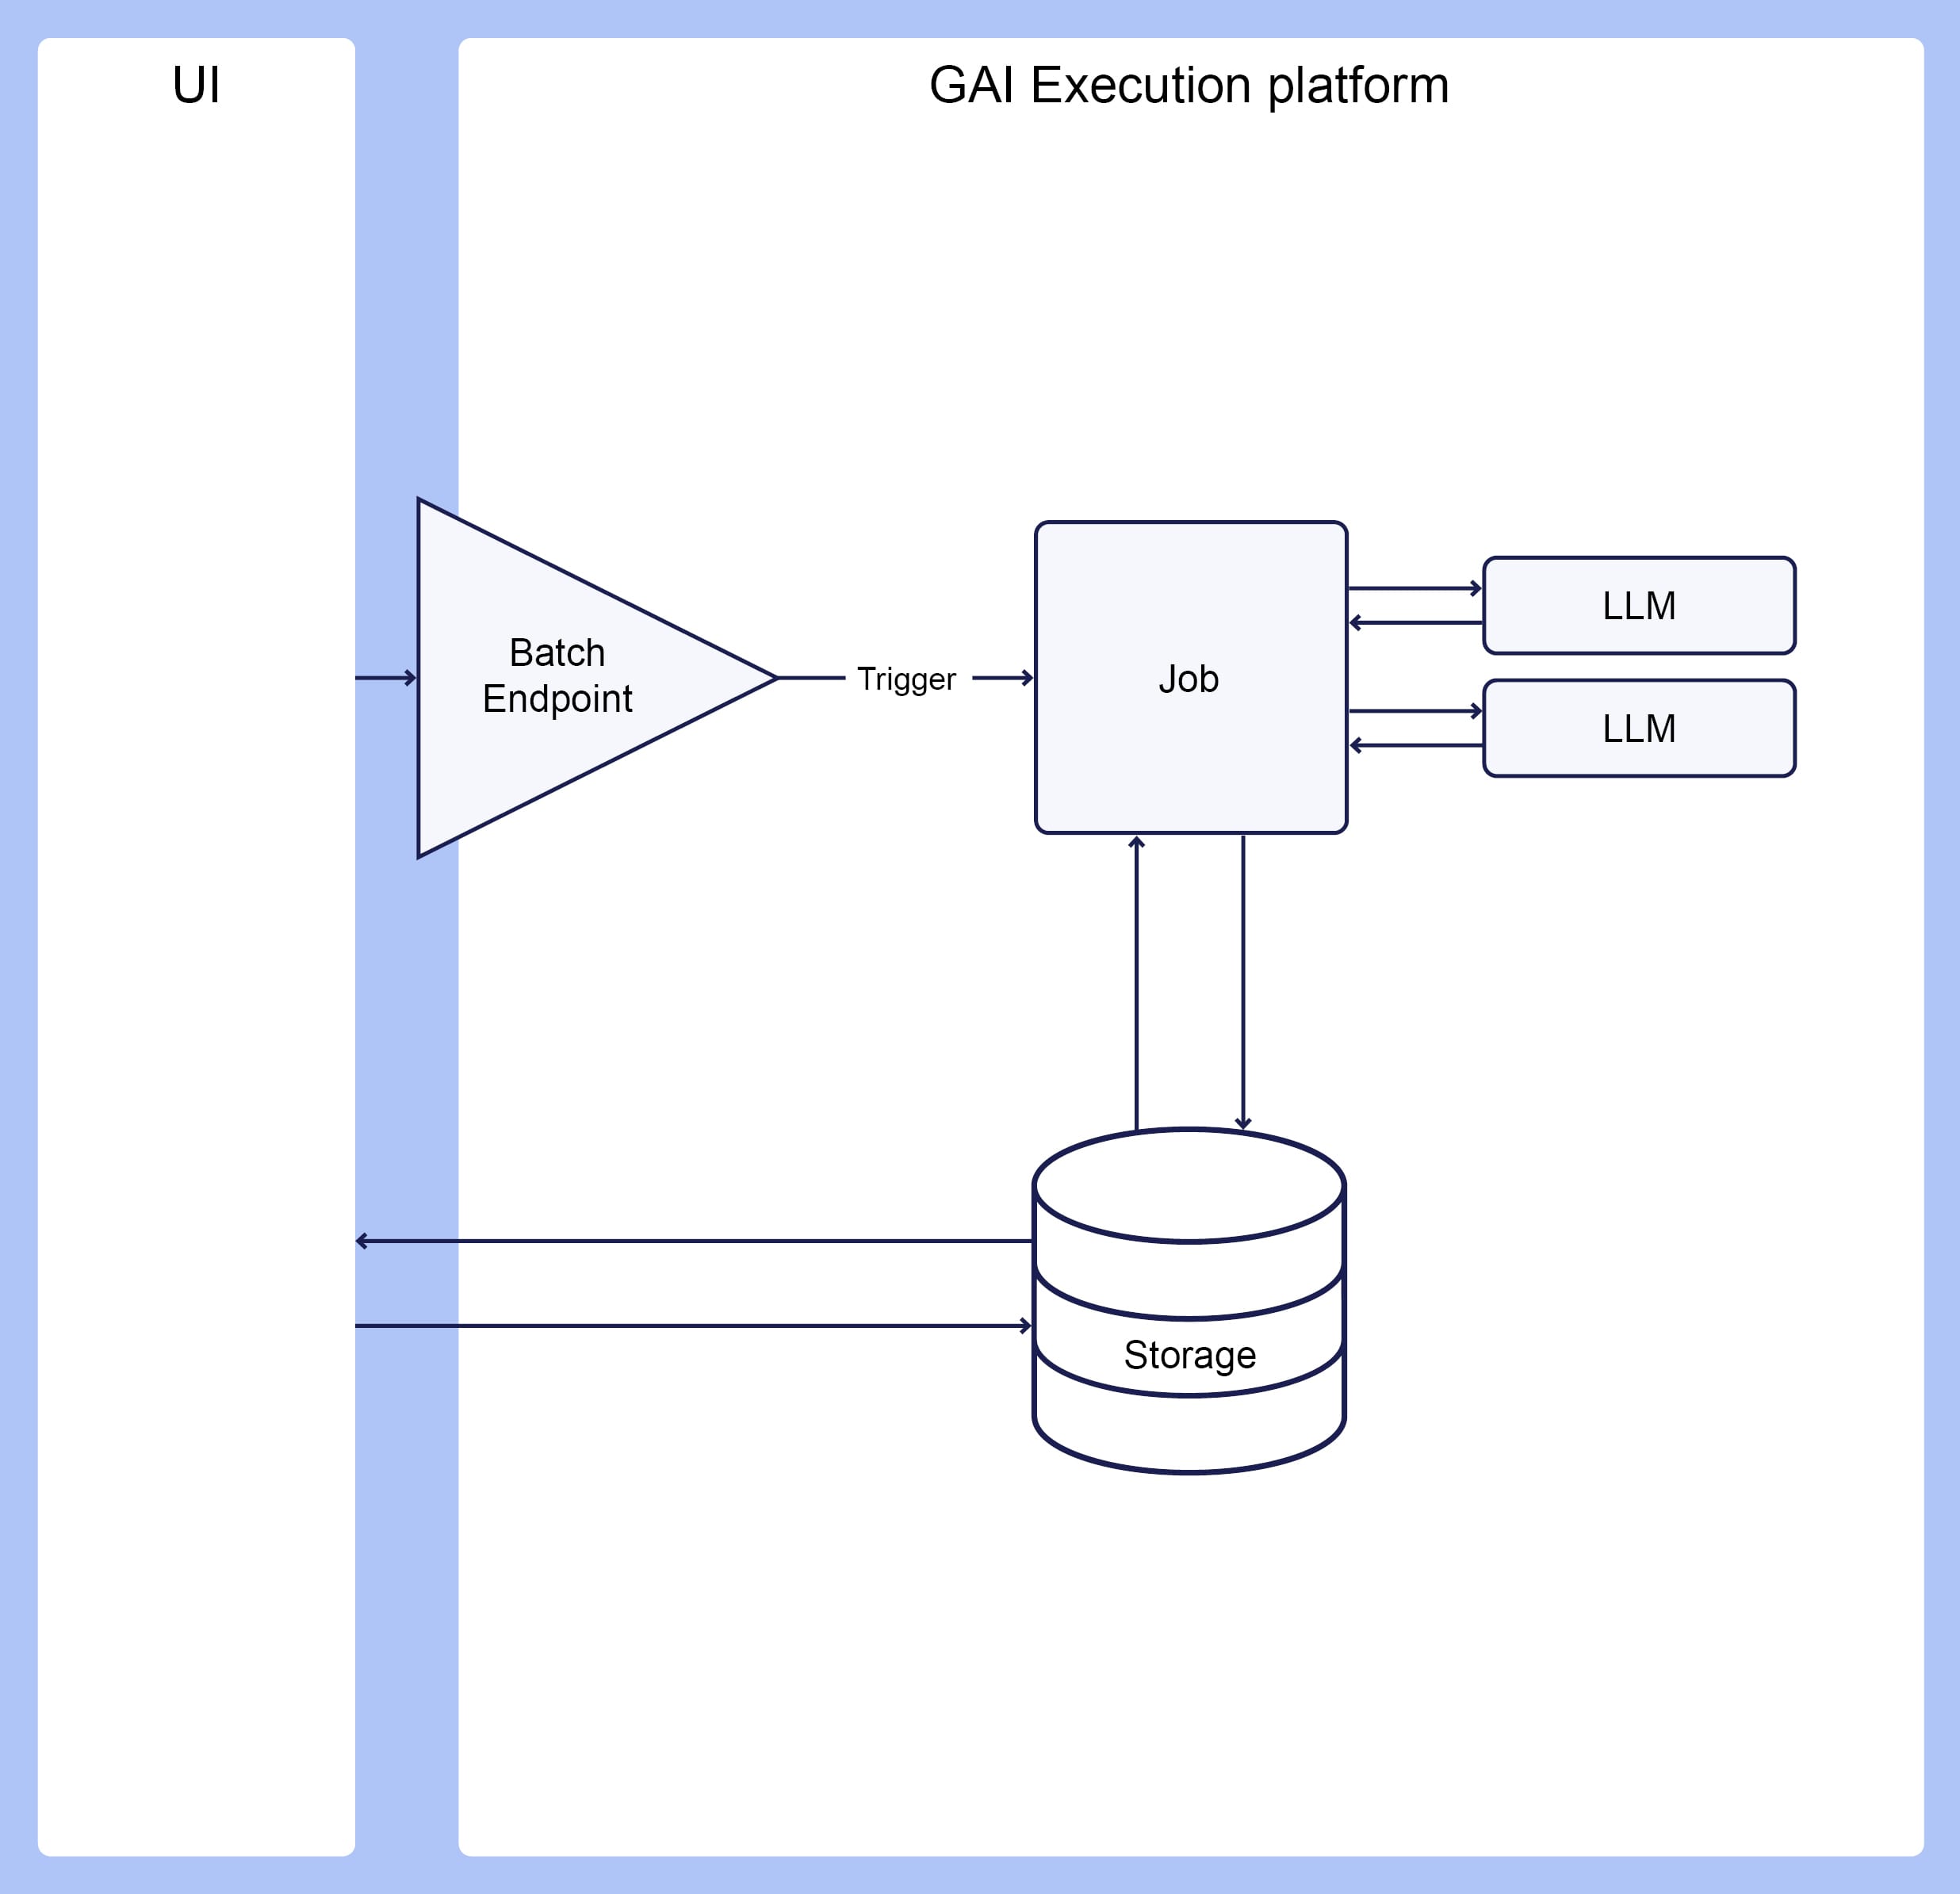
Bij Ephemeral RAG bestaat de vector-index alleen zolang je hem nodig hebt. Je bouwt de index op, gebruikt hem voor een specifieke verwerking en breekt hem daarna weer af.
Er hoeft dus geen infrastructuur permanent te blijven draaien.
Voorbeeld: een nachtelijke job die supporttickets verwerkt en samenvat, waarna de output wordt weggeschreven naar het warehouse.

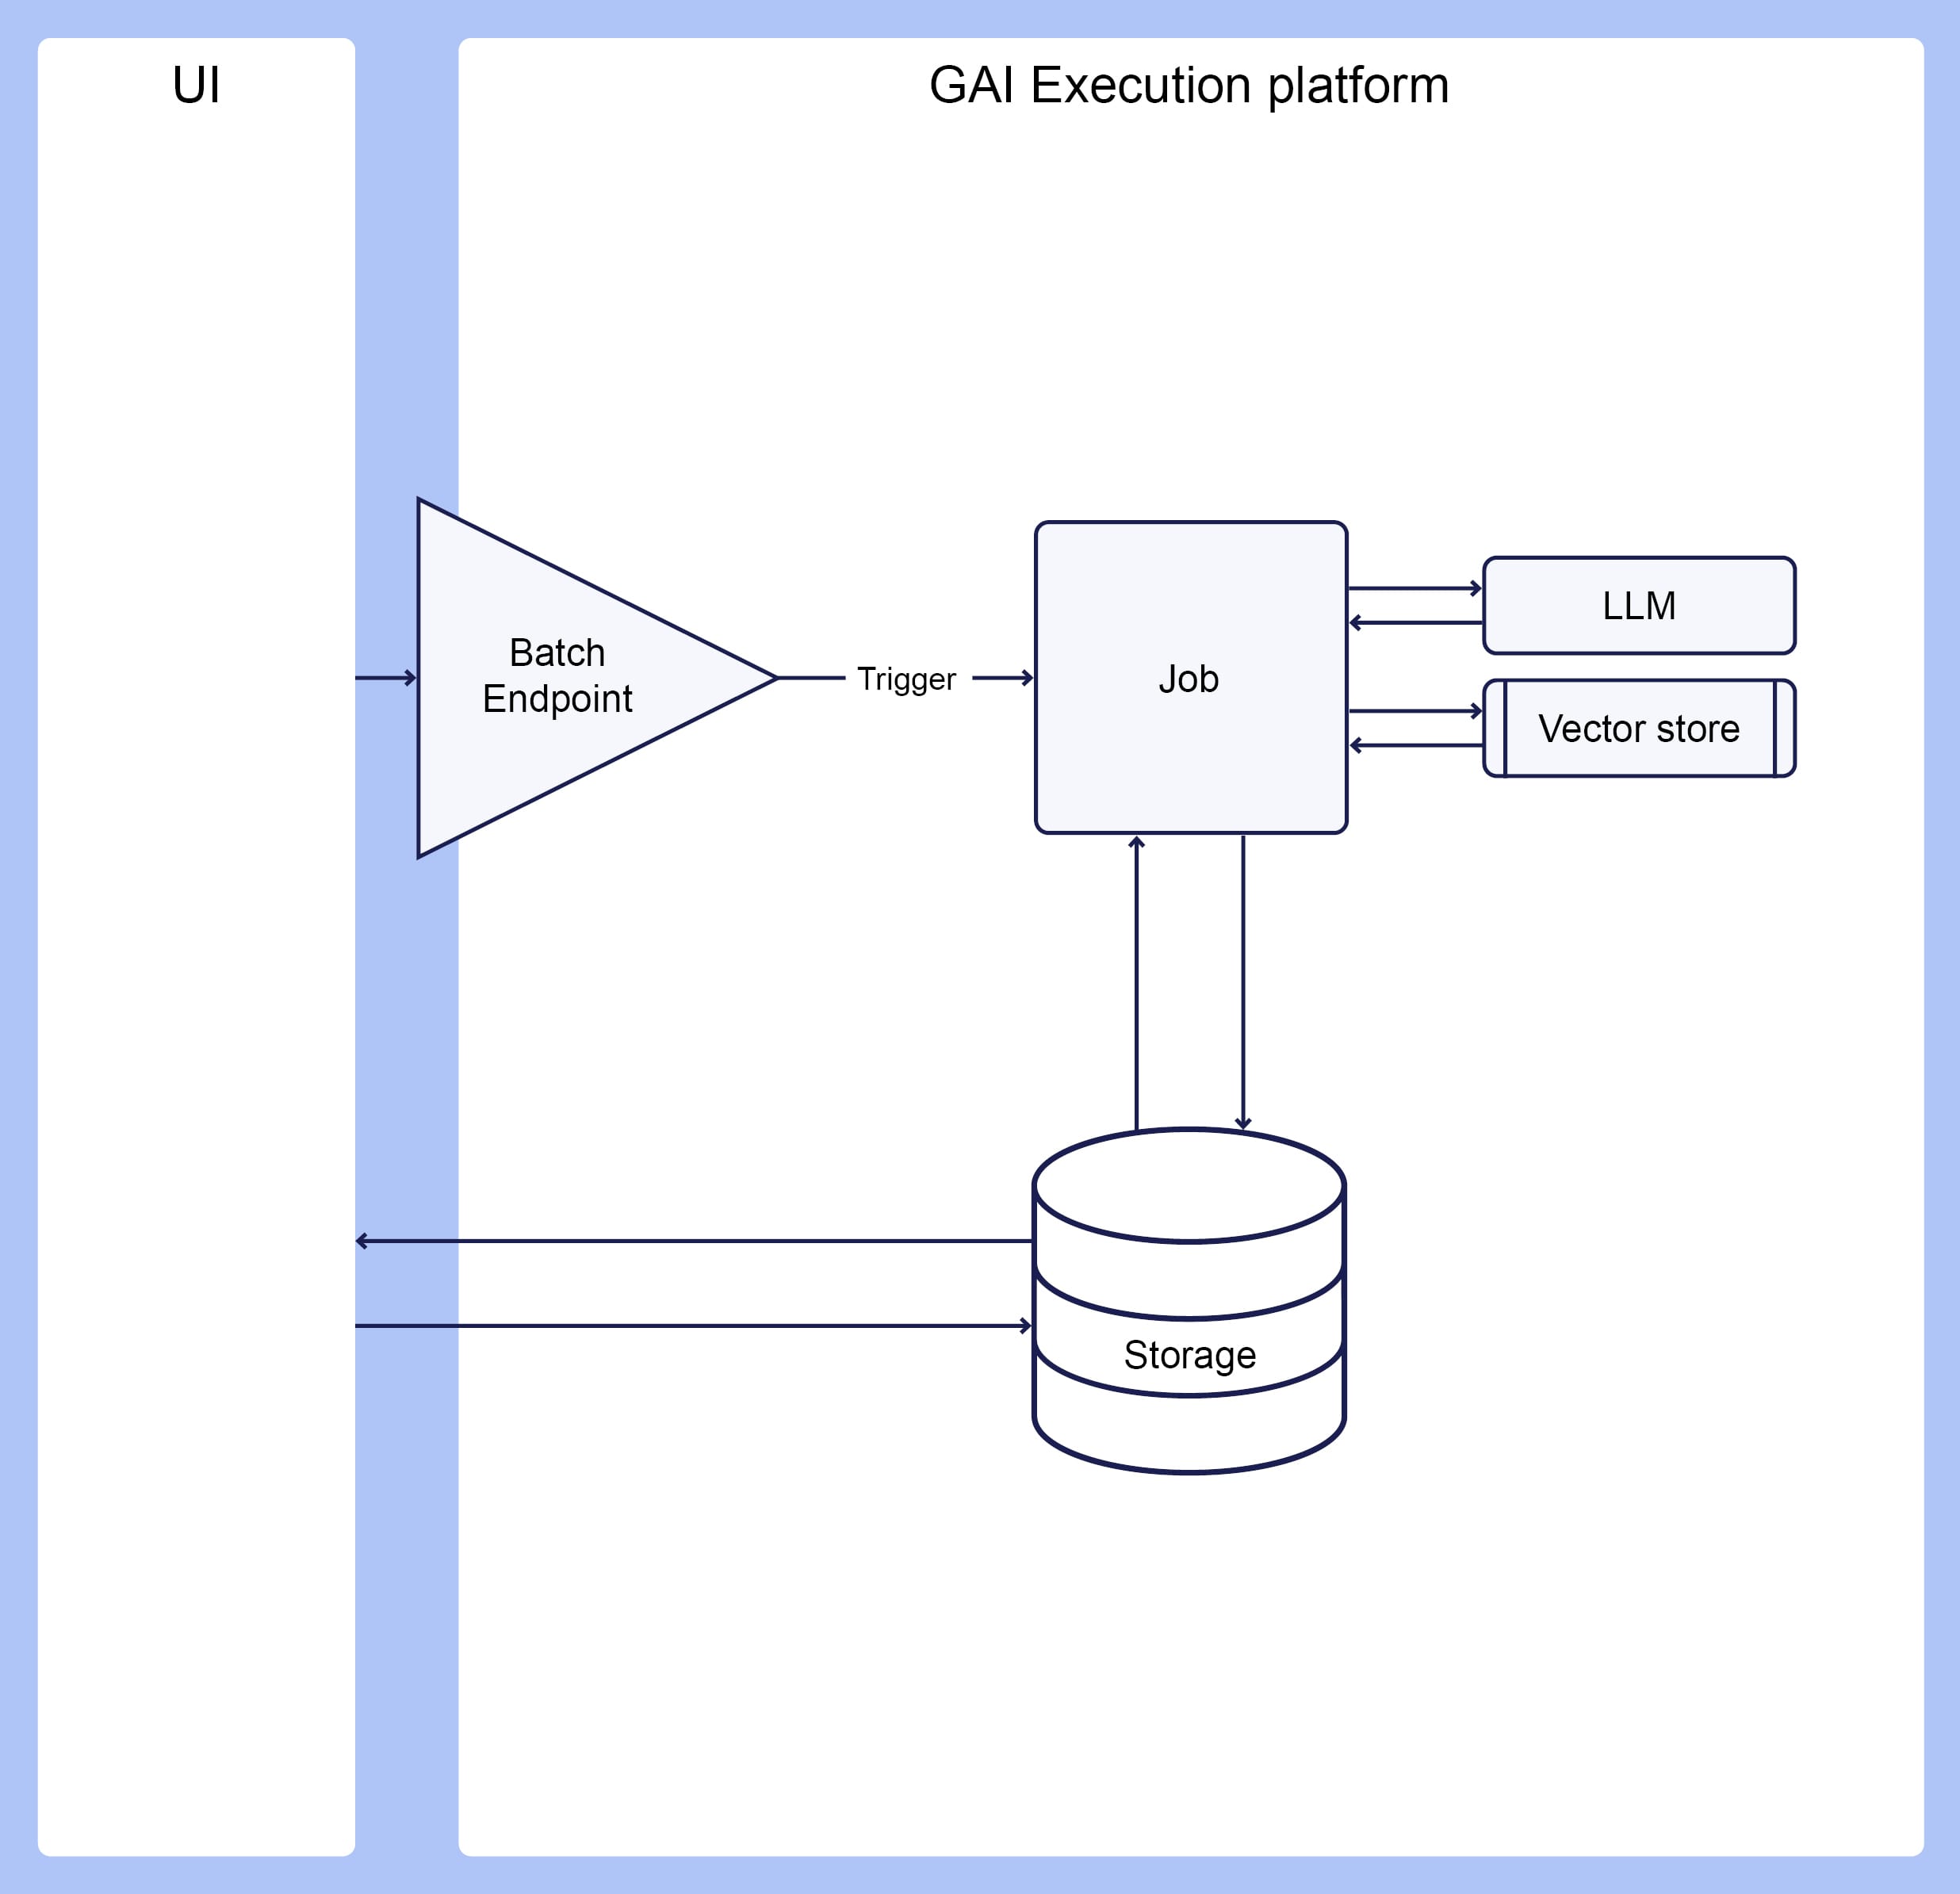
Persistent Index Building vormt de fundering onder de realtime RAG-patronen. Hierbij blijft een vector-index continu of periodiek gesynchroniseerd met de brondata.
Dit patroon raakt het meest aan klassiek platformwerk, alleen werk je naast traditionele tabellen ook met embeddings en een vector-index.
Voorbeeld: ongestructureerde data zoals offertes, pdf’s en handleidingen verwerken en permanent doorzoekbaar maken.

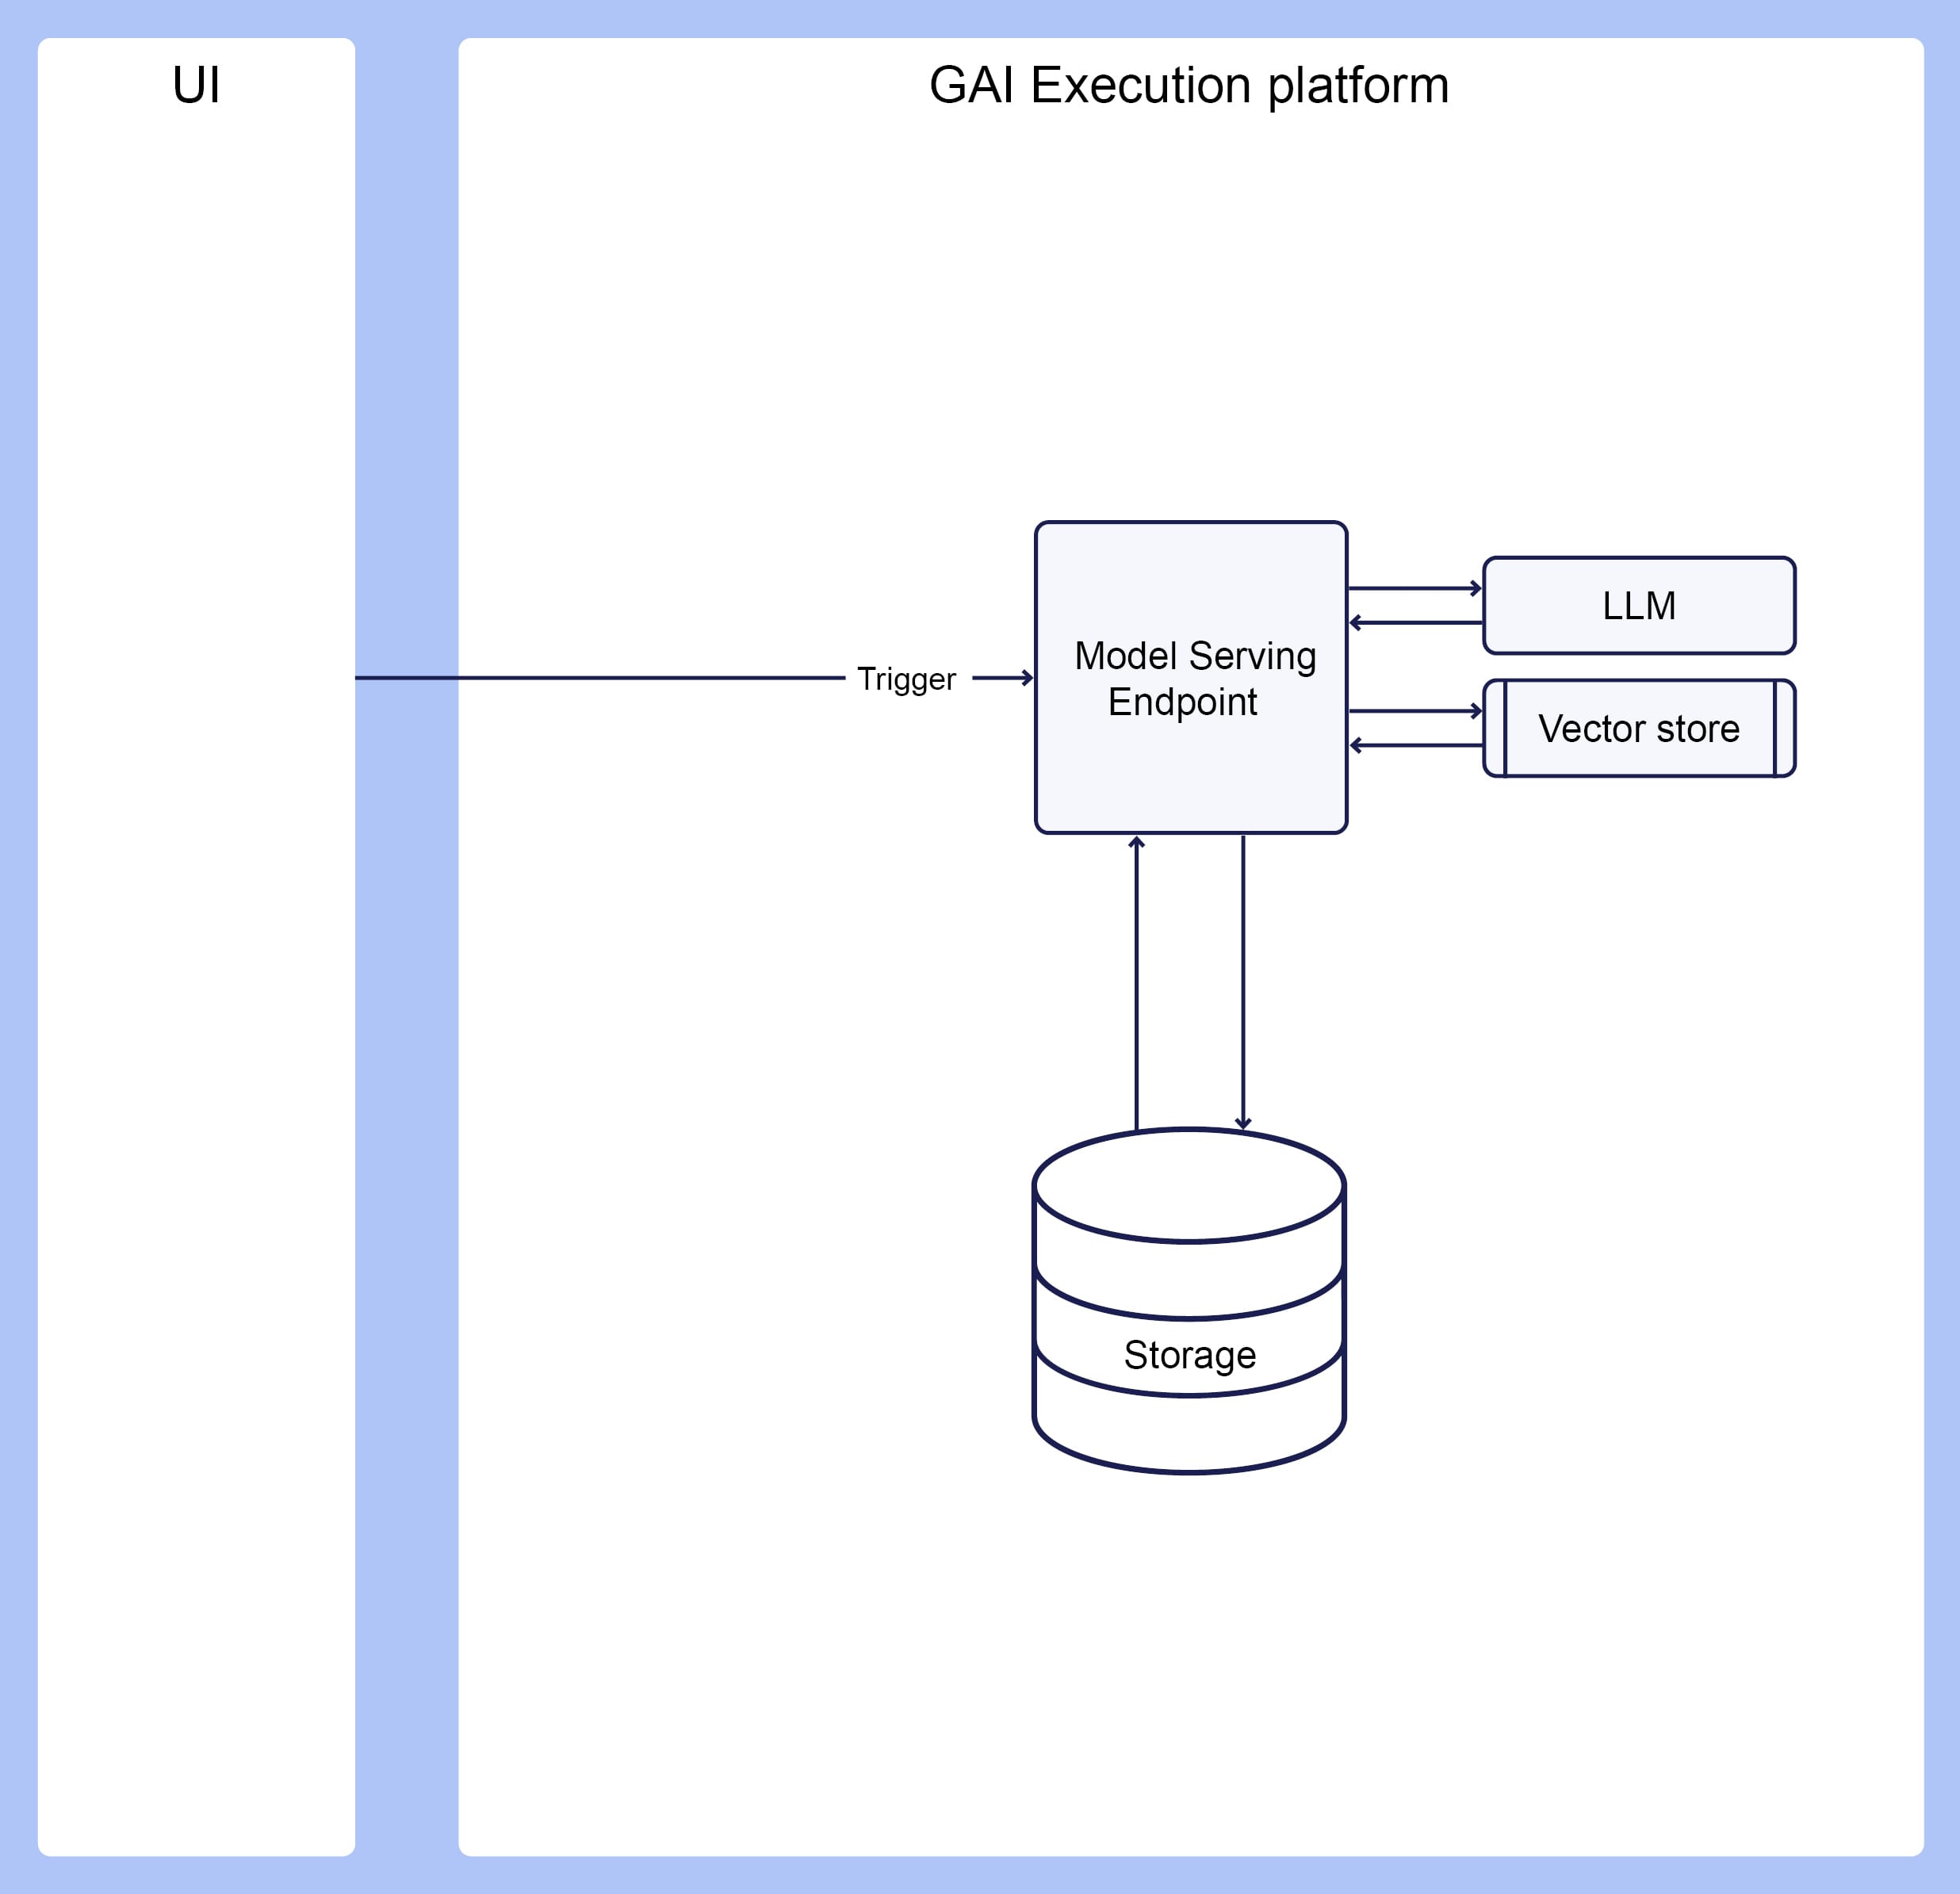
Online RAG is de eenvoudigste realtime variant: één vraag erin, één doorzocht en onderbouwd antwoord eruit.
Het systeem hoeft niets van eerdere vragen te onthouden. Iedere request kan in principe zelfstandig worden afgehandeld.
Voorbeeld: een interne zoektool waarmee medewerkers een vraag stellen en direct een antwoord met bronvermelding terugkrijgen.

Conversational RAG voegt geheugen toe aan Online RAG. Het systeem houdt rekening met wat eerder in het gesprek is gezegd, waardoor een gebruiker vervolgvragen kan stellen zonder steeds alle context opnieuw mee te geven.
Daarmee ontstaat naast retrieval een tweede vorm van state: de conversationele context.
Voorbeeld: een HR-chatbot waarmee medewerkers een gesprek kunnen voeren over interne informatie, inclusief vervolgvragen.

Bij Agentic RAG wordt het model actief. Retrieval is niet langer één vaste stap in de pipeline, maar één van de tools die het model zelf kan inzetten.
Een agent kan retrieval bovendien meerdere keren uitvoeren en aanvullende systemen raadplegen om tot een antwoord of actie te komen.
Voorbeeld: een assistent die het CRM bevraagt, contractvoorwaarden controleert en op basis daarvan een voorstel opstelt.
De keuze voor een RAG-architectuur wordt vooral bepaald door de benodigde snelheid, state en autonomie.
| RAG-patroon | Realtime | Geheugen | Toolgebruik | Typische toepassing |
|---|---|---|---|---|
| Ephemeral RAG | Nee | Nee | Nee | Batchverrijking |
| Persistent Index Building | n.v.t. | Nee | Nee | Actuele vector-index |
| Online RAG | Ja | Nee | Nee | Enterprise search |
| Conversational RAG | Ja | Ja | Nee | Chatbots en assistants |
| Agentic RAG | Ja | Ja | Ja | Agentic workflows |
Online RAG past bij losse realtime vragen. Conversational RAG is logischer wanneer gesprekshistorie onderdeel is van de usecase. Agentic RAG wordt relevant wanneer het systeem zelfstandig meerdere bronnen of tools moet kunnen raadplegen.
Voor ieder realtime patroon – Online, Conversational en Agentic RAG – geldt Persistent Index Building als fundering. Zonder een actuele, doorzoekbare index is er immers niets om betrouwbaar op te bevragen.
Het meest geavanceerde patroon is daarbij niet automatisch het beste. De juiste architectuur is de eenvoudigste architectuur die de benodigde capability betrouwbaar kan leveren.
Vroeg of laat loop je hier tegenaan: je hebt tienduizenden documenten geïndexeerd met een bepaald embedding-model en een half jaar later is er een model dat merkbaar beter presteert.
De verleiding is om gewoon over te schakelen. Het probleem is dat oude en nieuwe embeddings niet automatisch in dezelfde vectorruimte liggen. Daardoor kan de retrieval-kwaliteit ongemerkt inconsistent worden.
Een robuuste oplossing is een blue/green deployment. Je bouwt een volledig nieuwe index met het nieuwe embedding-model, test deze parallel en schakelt pas over wanneer de nieuwe index minstens zo goed presteert. De oude index blijft tijdelijk beschikbaar voor een rollback.
Is dat te kostbaar, dan kun je geleidelijk migreren: documenten batchgewijs opnieuw embedden en tijdelijk beide indexen bevragen.
Een derde mogelijkheid is de technical debt bewust accepteren: het oude model blijven gebruiken voor bestaande data en het nieuwe model alleen voor nieuwe content. Dat is een compromis, maar soms wel een bewuste architectuurkeuze.
Wat in alle gevallen helpt: tag embeddings vanaf dag één met de naam en versie van het embedding-model. Die ene regel metadata maakt een toekomstige migratie aanzienlijk beter beheersbaar.
Voor debugging en evaluatie is het niet genoeg om te weten dát een RAG-systeem een antwoord heeft gegeven. Je wilt kunnen reconstrueren waaróm het dat antwoord gaf.
Leg daarom per request minimaal vast:
Voor agentic systemen komt daar de volledige trace bovenop: welke tools zijn aangeroepen, in welke volgorde en met welke resultaten.
Zonder zo’n trace is een falende agent moeilijk te debuggen. Tools als LangSmith en MLflow Tracing zijn ontworpen om deze beslisboom inzichtelijk te maken.
RAG-monitoring speelt daarmee op drie niveaus tegelijk:
Alle drie zijn nodig om te bepalen of een RAG-systeem niet alleen technisch werkt, maar ook betrouwbaar en efficiënt in productie draait.
Agentic RAG vraagt om explicietere grenzen dan een traditionele RAG-pipeline. Het model bepaalt immers zelf welke tools het gebruikt en hoeveel tussenstappen het uitvoert.
Zonder grenzen kan een sessie te lang blijven doorredeneren, kunnen kosten oplopen of kan een agent systemen benaderen die buiten zijn taak vallen.
In een productieomgeving betekent dit dat je onder andere moet nadenken over:
Zodra een agent niet alleen tekst genereert, maar ook echte acties kan uitvoeren, worden deze guardrails onderdeel van de architectuur.
Toegangscontrole hoort bij retrieval plaats te vinden, niet pas als filter achteraf.
Als een gebruiker geen rechten heeft op een document, moet dat document buiten de opgehaalde context blijven. Een model zou de informatie dan überhaupt niet moeten ontvangen.
Daarmee wordt governance ook een architectuurvraag. Wie is bijvoorbeeld eigenaar van de vector store?
Wanneer het dataplatform-team alles beheert, ontstaat centrale governance, maar mogelijk ook een bottleneck voor het AI-team. Wanneer het AI-team zelfstandig infrastructuur beheert, kan het sneller bewegen, maar neemt het risico op datasilo’s en dubbele opslag toe.
Een mogelijke verdeling is daarom:
Zo blijft de governance centraal georganiseerd, terwijl AI-teams ruimte houden om hun eigen applicaties en retrieval-laag te ontwikkelen.
Geen van de vijf RAG-patronen is inherent beter.
Agentic RAG is niet het eindpunt waar iedere usecase naartoe moet groeien. En Ephemeral RAG is niet te simpel om serieus te nemen voor batchverrijking.
Ieder patroon ruilt complexiteit in voor een specifieke capability: realtime respons, gespreksgeheugen of toolgebruik. De juiste keuze – en vaak de juiste combinatie van patronen – hangt af van wat de usecase daadwerkelijk vraagt, niet van welk patroon het meest geavanceerd klinkt.
Wat het verschil maakt tussen een RAG-pilot die nooit het lab uitkomt en een RAG-platform dat betrouwbaar in productie draait, is zelden een groter model.
Het verschil zit in de architectuur eromheen: orchestratie, storage-sync, embedding-versionering, monitoring, security en toegangsbeheer moeten aansluiten op de werkelijke vorm van het probleem. Niet pas worden toegevoegd nadat er iets misgaat.
Een RAG-oplossing production-ready maken vraagt daarom niet alleen kennis van LLM’s, maar ook van data-architectuur, orchestratie, security en monitoring. Precies daar komen GenAI en data engineering samen.
Bij Blenddata ontwerpen en bouwen we die infrastructuur als onderdeel van onze GenAI-platformtrajecten.
RAG staat voor Retrieval-Augmented Generation. Het is een AI-architectuur waarbij relevante informatie uit externe databronnen wordt opgehaald en als context aan een taalmodel wordt meegegeven voordat het model een antwoord genereert.
Een eenvoudige RAG-architectuur bestaat uit retrieval, augmentation en generation. In een enterprise-omgeving komen daar componenten bij voor onder andere indexering, storage, synchronisatie, monitoring, security en governance.
Bij traditionele RAG is retrieval een vooraf bepaalde stap in de pipeline. Bij Agentic RAG kan het model zelf bepalen wanneer het informatie moet ophalen, welke tools het gebruikt en welke vervolgstappen nodig zijn.
Een vector-index wordt gebruikt om informatie semantisch doorzoekbaar te maken. Bij Online, Conversational en Agentic RAG moet deze index actueel en beschikbaar blijven om realtime retrieval mogelijk te maken.
Monitor zowel de technische prestaties als de kwaliteit en kosten. Denk aan latency en errors, opgehaalde chunks, uiteindelijke prompts en antwoorden, tokengebruik en – bij agentic systemen – de volledige reeks tool-calls.
Toegangscontrole moet al tijdens retrieval worden toegepast. Documenten waarvoor een gebruiker geen rechten heeft, mogen niet worden opgenomen in de context die naar het taalmodel gaat.
Agentic RAG is relevant wanneer een systeem niet alleen informatie hoeft op te halen, maar zelfstandig meerdere bronnen of tools moet raadplegen om een taak uit te voeren. Wanneer één retrieval-stap voldoende is, zorgt een eenvoudiger RAG-patroon doorgaans voor minder architecturale complexiteit.
Neem gerust contact op! We helpen je graag verder.